Über die Crawlbarkeit von Websites
Was bedeutet Crawlbarkeit?
Eine Seite ist crawlbar, wenn eine Suchmaschine sie erreichen darf, sie abrufen darf und bei ihrer Ankunft etwas vorfindet, das es wert ist, gespeichert zu werden. Fehlt eine dieser Voraussetzungen, ist die Seite praktisch unsichtbar – ganz gleich, wie gut der Inhalt ist.
Es ist der Schritt, der allem anderen vorausgeht. Rankings, Snippets und KI-Zitate setzen allesamt voraus, dass die Seite überhaupt in den Index aufgenommen wurde. Wenn eine Seite einfach nicht erscheint, ist es daher sinnvoll, zunächst die Crawlbarkeit der Website zu testen, anstatt sofort mit der Überarbeitung der Inhalte zu beginnen.
Das Unangenehme daran ist, dass jeder dieser Fehler unbemerkt bleibt. Nichts geht kaputt, es wird kein Fehler angezeigt, die Seite sieht für Sie perfekt aus – sie taucht einfach nie auf.
Die vier Dinge, die verhindern, dass eine Seite indexiert wird
Fast jedes Crawlbarkeitsproblem fällt in eine dieser Kategorien, und sie treten in einer bestimmten Reihenfolge auf:
- Die URL wird nicht aufgelöst – es tritt ein 404-Fehler, ein Serverfehler oder eine Weiterleitungskette auf, die abbricht.
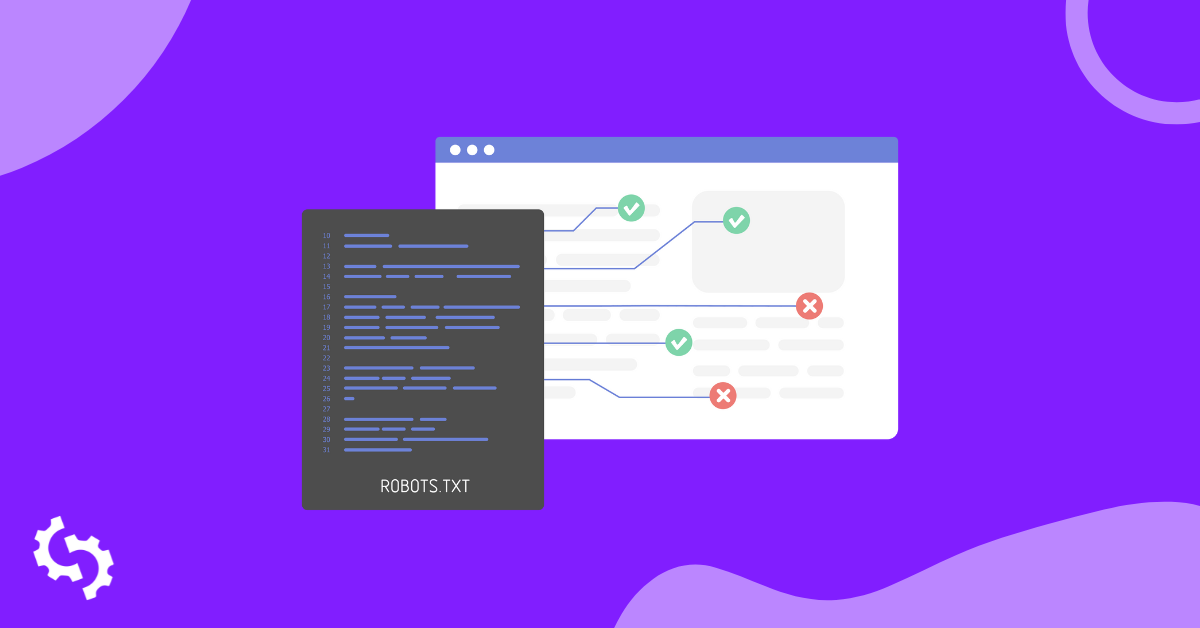
- Die robots.txt-Datei verbietet dem Crawler den Zugriff, sodass die Seite überhaupt nicht abgerufen wird.
- Eine noindex-Anweisung weist die Suchmaschine an, die Seite abzurufen, sie jedoch aus den Suchergebnissen herauszuhalten.
- Die Seite enthält ohne JavaScript kaum Inhalte, sodass nur wenig indexiert werden kann.
Die Reihenfolge ist wichtig, wenn du diese Probleme behebst. Eine Sperre in der robots.txt bedeutet, dass das darunterstehende noindex-Tag überhaupt nicht gelesen wird. Die Kombination aus beidem bewirkt daher das Gegenteil von dem, was viele erwarten: Das Crawling der Seite bleibt blockiert, und ihre Anweisung zur Entfernung wird nicht erkannt.
Robots.txt und noindex sind nicht dasselbe.
Dies ist die Verwechslung, die den größten Schaden verursacht. Die robots.txt steuert, ob ein Crawler eine Seite abrufen darf; noindex steuert, ob er sie behalten darf. Sie greifen in unterschiedlichen Phasen und sind nicht austauschbar.
Um eine Seite aus den Suchergebnissen herauszuhalten, benötigen Sie noindex, und der Crawler muss die Seite abrufen dürfen, um dies zu erkennen. Eine Sperrung in der robots.txt kann stattdessen dazu führen, dass eine URL ganz ohne Beschreibung aufgeführt wird, da die Suchmaschine die Adresse kennt, aber nie die Erlaubnis hatte, sie zu überprüfen.
Für den umgekehrten Fall – eine Seite, die tatsächlich gefunden werden soll – müssen beide Angaben eindeutig sein, und die Noindex-Anweisung kann entweder im HTML oder in einem HTTP-Header enthalten sein. Die Variante im Header führt häufig zu Problemen, da sie im Quellcode der Seite nicht sichtbar ist.
KI-Crawler sind im Jahr 2026 eine separate Entscheidung
Die KI-Unternehmen betreiben ihre eigenen benannten Crawler, und sie zu blockieren ist eine andere Entscheidung als das Blockieren von Suchmaschinen. GPTBot, ClaudeBot, PerplexityBot und die übrigen Crawler verfolgen jeweils ihre eigene Regelung in der robots.txt.
Viele Websites haben sie blockiert, ohne dies wirklich beabsichtigt zu haben – oft, indem sie eine robots.txt-Datei von einer anderen Website kopiert haben. Wenn es Ihnen wichtig ist, in KI-Antworten zitiert zu werden, sollten Sie davon wissen, statt es erst später festzustellen.
Das Gegenteil ist ebenfalls eine legitime Entscheidung. Wenn Sie nicht möchten, dass Ihre Inhalte zum Trainieren von Modellen oder für Zusammenfassungen verwendet werden, können Sie dies durch das Blockieren dieser Bots zum Ausdruck bringen – entscheidend ist, dass es eine bewusste Entscheidung und kein Versehen ist.
So testen Sie die Crawlability einer Website mit diesem Tool
Geben Sie eine URL ein. Das Tool führt elf Prüfungen dafür durch und meldet jede einzeln – in der Reihenfolge, in der ein Crawler auf sie trifft:
- Seite erreichbar – der Statuscode, den die URL zurückgibt.
- Suchmaschinen blockiert – ob robots.txt den Googlebot ausschließt.
- KI-Crawler blockiert – wie viele der wichtigsten KI-User-Agents ausgeschlossen sind.
- Noindex-Tag – eine Noindex-Direktive im HTML-Code der Seite.
- Noindex-Header – dieselbe Direktive, die als X-Robots-Tag übermittelt wird.
- Robots.txt – ob die Datei vorhanden ist und welchen Inhalt sie hat.
- XML-Sitemap – ob eine solche Sitemap vorhanden ist, damit Crawler den Rest der Website entdecken können.
- Llms.txt – ob die Datei vorhanden ist, nach der KI-Assistenten suchen.
- Canonical-Tag – welche URL die Seite als die zu indexierende URL angibt.
- Gerenderter Inhalt – wie viel von der Seite ein Crawler sieht, ohne JavaScript auszuführen.
- JavaScript-Fehler – Skripte, die auf der Seite fehlschlagen, was häufig der Grund für den geringen Umfang des gerenderten Inhalts ist.
Das Tool prüft die einzelne URL, die Sie angeben, statt die gesamte Website zu crawlen. Testen Sie daher die Crawlbarkeit der Website auf der tatsächlich fehlenden Seite und nicht auf der Startseite – die beiden unterscheiden sich häufig, und die Startseite ist nur selten die Seite mit dem Problem.
Wie es weitergeht
Wenn hier alles erfolgreich ist und die Seite trotzdem nicht angezeigt wird, sollten Sie als Nächstes die Auffindbarkeit überprüfen. Prüfen Sie, ob die Seite in Ihrer
XML-Sitemap aufgeführt ist, sehen Sie sich die gesamte
robots.txt-Datei statt nur die Regeln für einen einzelnen Agenten an und prüfen Sie mit dem
interner Link-Checker, ob auf der Website auf die Seite verlinkt wird.