Tentang Kemampuan Perayapan Situs Web
Apa yang dimaksud dengan kemampuan perayapan?
Sebuah halaman dapat dirayapi ketika mesin pencari dapat menjangkaunya, diizinkan untuk mengambilnya, dan menemukan sesuatu yang layak disimpan setelah tiba di halaman tersebut. Jika salah satu dari hal tersebut gagal, halaman itu pada dasarnya tidak terlihat, sebaik apa pun kontennya.
Ini adalah langkah sebelum segala hal lainnya. Peringkat, cuplikan, kutipan AI—semuanya mengasumsikan bahwa halaman tersebut sudah masuk ke indeks sejak awal. Jadi, langkah pertama yang masuk akal ketika sebuah halaman sama sekali tidak muncul adalah menguji kemampuan situs untuk dirayapi, bukan langsung menulis ulang kontennya.
Bagian yang menyulitkan adalah semua kegagalan ini terjadi secara diam-diam. Tidak ada yang rusak, tidak ada pesan error, dan halaman tersebut terlihat sempurna bagi Anda—tetapi halaman itu tidak pernah muncul.
Empat hal yang menyebabkan halaman tidak diindeks
Hampir setiap masalah kemampuan perayapan termasuk dalam salah satu hal berikut, dan masalah-masalah ini terjadi dalam urutan tertentu:
- URL tidak dapat diakses—menghasilkan 404, kesalahan server, atau rangkaian pengalihan yang terhenti.
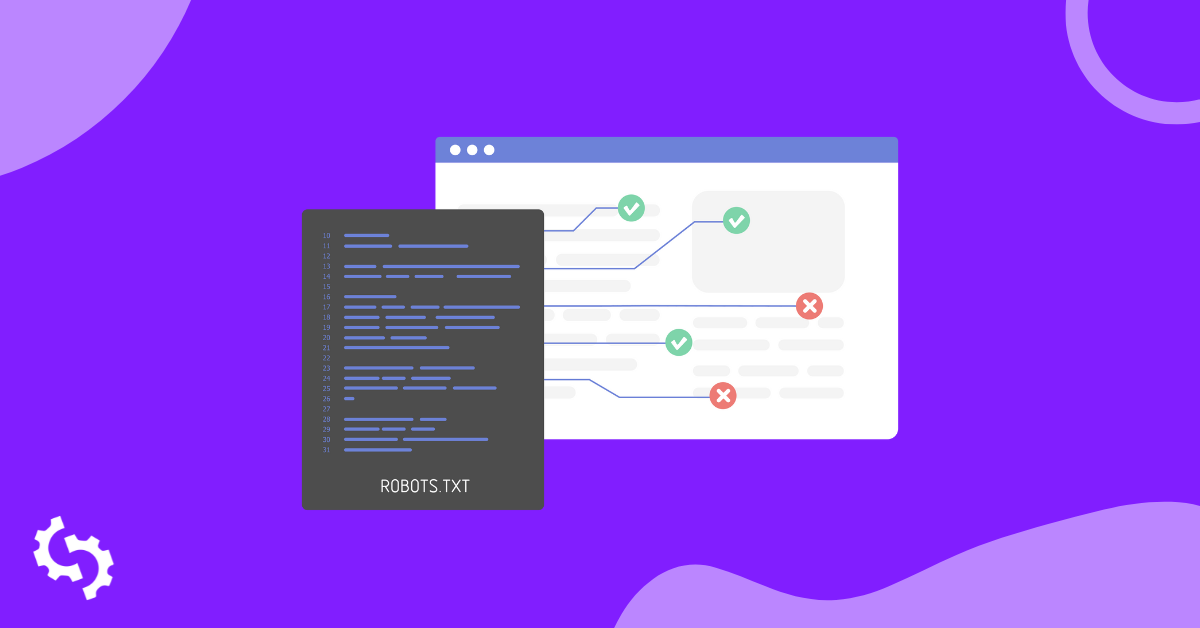
- Robots.txt melarang perayap, sehingga halaman sama sekali tidak pernah diambil.
- Direktif noindex memberi tahu mesin pencari untuk mengambil halaman, tetapi tidak menampilkannya dalam hasil pencarian.
- Halaman hampir tidak menampilkan apa pun tanpa JavaScript, sehingga hanya sedikit konten yang dapat diindeks.
Urutannya penting saat Anda memperbaikinya. Pemblokiran melalui robots.txt berarti tag noindex di bawahnya bahkan tidak pernah dibaca, sehingga menggabungkan keduanya menghasilkan hal yang berlawanan dari yang diharapkan—halaman tetap diblokir dari perayapan dan instruksi untuk menghapusnya tidak terlihat.
Robots.txt dan noindex bukanlah hal yang sama
Inilah kebingungan yang paling banyak menimbulkan dampak buruk. Robots.txt mengontrol apakah crawler boleh mengambil halaman; noindex mengontrol apakah crawler boleh menyimpannya. Keduanya beroperasi pada tahap yang berbeda dan tidak dapat saling menggantikan.
Untuk mencegah halaman muncul di hasil penelusuran, Anda memerlukan noindex, dan crawler harus diizinkan mengambil halaman tersebut agar dapat melihatnya. Sebaliknya, memblokirnya di robots.txt dapat menyebabkan URL tetap tercantum tanpa deskripsi sama sekali, karena mesin pencari mengetahui alamatnya tetapi tidak pernah diizinkan untuk melihat isinya.
Sebaliknya—untuk halaman yang memang ingin Anda ditemukan—keduanya harus jelas, dan noindex dapat muncul dalam HTML atau header HTTP. Versi header sering mengecoh orang, karena tidak terlihat di sumber halaman.
Crawler AI adalah keputusan terpisah pada 2026
Perusahaan AI menjalankan crawler mereka sendiri dengan nama khusus, dan memblokirnya merupakan pilihan yang berbeda dari memblokir mesin pencari. GPTBot, ClaudeBot, PerplexityBot, dan lainnya masing-masing memiliki aturan sendiri di robots.txt.
Banyak situs telah memblokirnya tanpa sengaja, sering kali karena menyalin robots.txt dari tempat lain. Jika situs Anda ingin dikutip dalam jawaban AI, hal ini penting untuk diketahui daripada baru menyadarinya nanti.
Sebaliknya, memilih untuk tidak mengizinkan penggunaan konten Anda juga merupakan keputusan yang sah. Jika Anda tidak ingin konten Anda digunakan untuk pelatihan atau diringkas, memblokir agen-agen tersebut adalah cara untuk menyatakannya—intinya, keputusan itu seharusnya disengaja, bukan terjadi secara tidak sengaja.
Cara menguji keterayapan situs web dengan alat ini
Masukkan URL dan alat ini menjalankan sebelas pemeriksaan terhadapnya, lalu melaporkan masing-masing secara terpisah, sesuai urutan saat crawler menemukannya:
- Halaman dapat diakses - kode status yang dikembalikan URL tersebut.
- Mesin pencari diblokir - apakah robots.txt melarang Googlebot.
- Crawler AI diblokir - berapa banyak user agent AI utama yang tidak diizinkan.
- Tag noindex - direktif noindex dalam HTML halaman.
- Header noindex - direktif yang sama, dikirim sebagai X-Robots-Tag.
- Robots.txt - apakah file tersebut ada dan apa isinya.
- Sitemap XML - apakah ada sitemap untuk membantu crawler menemukan bagian situs lainnya.
- Llms.txt - apakah file yang dicari oleh asisten AI tersedia.
- Tag kanonis - URL yang ditetapkan halaman sebagai URL yang akan diindeks.
- Konten yang dirender - seberapa banyak bagian halaman yang dapat dilihat crawler tanpa menjalankan JavaScript.
- Error JavaScript - skrip yang gagal dijalankan di halaman, yang sering kali menjadi penyebab tipisnya konten yang dirender.
Fitur ini memeriksa satu URL yang Anda berikan, bukan merayapi seluruh situs, jadi uji ketercrawlan situs pada halaman yang benar-benar bermasalah, bukan pada beranda - keduanya sering kali berbeda, dan beranda jarang menjadi halaman yang mengalami masalah tersebut.
Ke mana selanjutnya
Jika semua pemeriksaan di sini berhasil tetapi halaman masih belum muncul, keterjangkauan adalah hal berikutnya yang perlu diperiksa. Pastikan halaman tercantum di
Peta situs XML, tinjau seluruh file
robots.txt, bukan hanya aturan untuk satu agen, dan periksa apakah ada bagian di situs yang menautkannya menggunakan pemeriksa
tautan internal.