Tester la crawlabilité du site
Le test gratuit de crawlabilité de SEOptimer vérifie si les moteurs de recherche et les robots d’exploration IA peuvent accéder à votre page, la récupérer et l’indexer : règles de robots.txt, directives noindex, code d’état et quantité de contenu réellement affichée.

Auditez n’importe quel site en quelques secondes
+ Des outils SEO / GEO complets pour chaque fonctionnalité
Effectuez plus de 100 vérifications sur votre site concernant le SEO on-page, l’utilisabilité, les performances, les réseaux sociaux et les liens. Désormais avec le GEO dans chaque rapport. SEOptimer propose également la recherche de mots-clés, le suivi du classement, l’analyse des backlinks et un crawler complet du site.

À propos de l’explorabilité d’un site Web
Que signifie « explorabilité » ?
Les quatre éléments qui empêchent une page d’être indexée
- L’URL n’aboutit pas : erreur 404, erreur serveur ou chaîne de redirections qui n’aboutit pas.
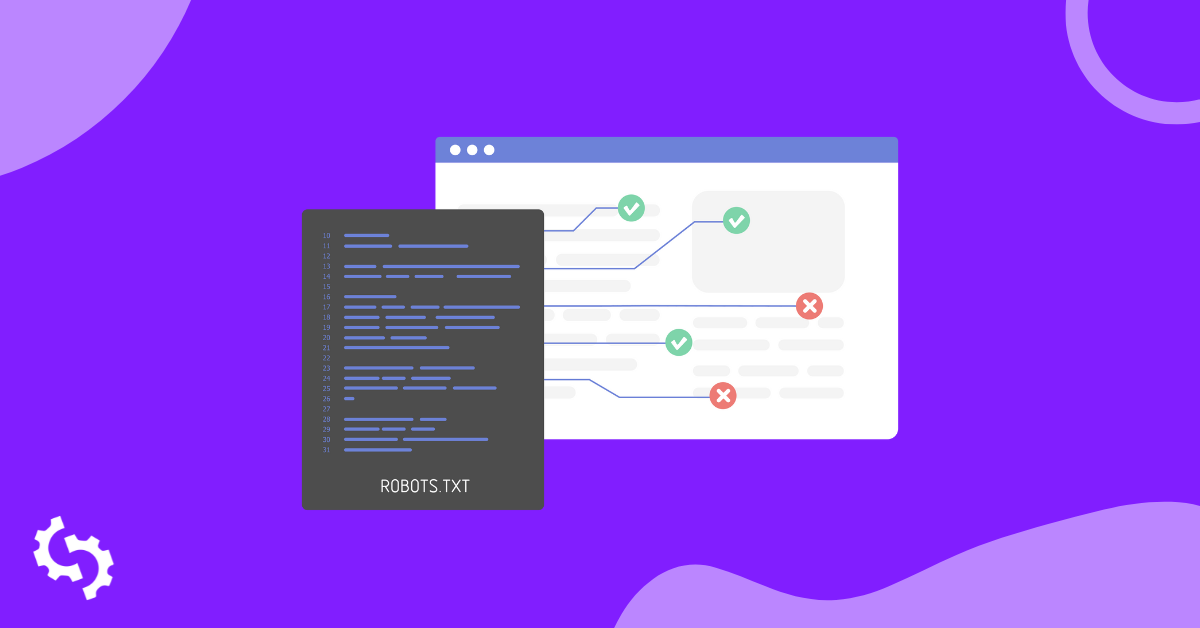
- Le fichier robots.txt interdit l’exploration, la page n’est donc jamais récupérée.
- Une directive noindex indique au moteur de récupérer la page, mais de l’exclure des résultats.
- La page n’affiche presque rien sans JavaScript, il y a donc peu de contenu à indexer.
Le fichier robots.txt et la directive noindex, ce n’est pas la même chose
Les robots d’exploration IA constituent une décision distincte en 2026
Comment tester l’explorabilité d’un site web avec cet outil
- Page accessible - le code d’état renvoyé par l’URL.
- Moteurs de recherche bloqués - indique si robots.txt interdit l’accès à Googlebot.
- Robots d’exploration IA bloqués - le nombre de principaux agents utilisateurs IA dont l’accès est interdit.
- Balise noindex - une directive noindex dans le code HTML de la page.
- En-tête noindex - la même directive transmise via un en-tête X-Robots-Tag.
- Robots.txt - indique si le fichier existe et ce qu’il contient.
- Sitemap XML - indique si un sitemap existe pour permettre aux robots d’exploration de découvrir le reste du site.
- Llms.txt - indique si le fichier recherché par les assistants IA est présent.
- Balise canonique - indique quelle URL la page désigne comme étant celle à indexer.
- Contenu rendu - indique quelle quantité de contenu de la page un robot d’exploration voit sans exécuter JavaScript.
- Erreurs JavaScript - scripts qui échouent sur la page, ce qui explique souvent pourquoi le contenu rendu est limité.
Pour aller plus loin

Boîte à outils SEO complète avec plus de 55 outils
Vérifiez les titres, les méta-descriptions, les en-têtes, les données structurées Schema, les Core Web Vitals, le SSL et le fichier robots.txt. Générez des balises méta, des sitemaps et des règles .htaccess, minifiez vos fichiers CSS, JS et HTML, et rédigez du contenu grâce à nos outils de rédaction IA — instantanément et gratuitement.
Lectures complémentaires
Voir plus