Testar a capacidade de rastreio do site
O teste gratuito de capacidade de rastreio da SEOptimer verifica se os motores de pesquisa e os rastreadores de IA conseguem aceder, obter e indexar a sua página — regras do robots.txt, diretivas noindex, código de estado e a quantidade de conteúdo efetivamente renderizado.

Audite qualquer site em segundos
+ Ferramentas abrangentes de SEO / GEO para todas as funções
Execute mais de 100 verificações no seu site em SEO On-Page, Usabilidade, Desempenho, Redes sociais e Ligações. Agora com GEO em todos os relatórios. O SEOptimer também oferece pesquisa de palavras-chave, monitorização de posições, backlinks e um crawler completo do site.

Sobre a rastreabilidade do site
O que significa rastreabilidade?
As quatro coisas que impedem uma página de ser indexada
- O URL não é resolvido — um erro 404, um erro do servidor ou uma cadeia de redireccionamentos que termina sem sucesso.
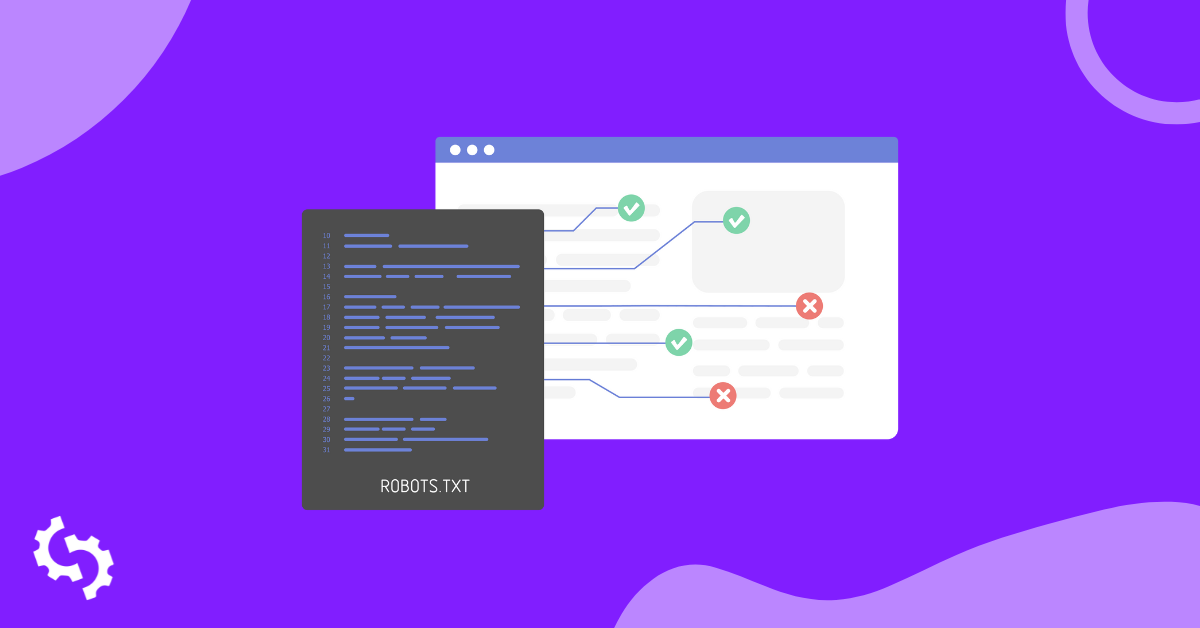
- O robots.txt impede o rastreador, pelo que a página nunca chega a ser obtida.
- Uma directiva noindex indica ao motor de pesquisa que deve obter a página, mas mantê-la fora dos resultados.
- A página apresenta quase nada sem JavaScript, pelo que há pouco conteúdo para indexar.
Robots.txt e noindex não são a mesma coisa
Os crawlers de IA são uma decisão à parte em 2026
Como testar a capacidade de rastreamento de um site com esta ferramenta
- Página acessível — o código de estado devolvido pelo URL.
- Motores de pesquisa bloqueados — se o robots.txt impede o acesso do Googlebot.
- Rastreadores de IA bloqueados — quantos dos principais agentes de utilizador de IA não têm acesso permitido.
- Etiqueta noindex — uma diretiva noindex no HTML da página.
- Cabeçalho noindex — a mesma diretiva transmitida como um X-Robots-Tag.
- Robots.txt — se o ficheiro existe e o que contém.
- Mapa do site XML — se existe um, para que os rastreadores possam descobrir o resto do site.
- Llms.txt - se o ficheiro que os assistentes de IA procuram está presente.
- Etiqueta canónica - qual o URL que a página indica como aquele que deve ser indexado.
- Conteúdo renderizado - quanto da página um crawler consegue ver sem executar JavaScript.
- Erros de JavaScript - scripts que falham na página, o que muitas vezes explica o conteúdo renderizado reduzido.
Próximos passos

Caixa de ferramentas abrangente de SEO com mais de 55 ferramentas
Verifique Títulos, Meta descrições, Cabeçalhos, Schema, Core Web Vitals, SSL e Robots.txt. Gere Meta tags, Sitemaps e regras .htaccess, minimize CSS, JS e HTML e crie textos com as nossas ferramentas de escrita com IA — instantaneamente e de forma gratuita.
Leituras adicionais
Ver Mais