FAQ Generator
Genereer relevante FAQ-vragen met onze AI FAQ Generator. Voer gewoon je onderwerp in, kies een taal en toon en ontvang een aangepaste lijst met veelgestelde vragen.
Invoer
Uitvoer
Gegenereerde inhoud:
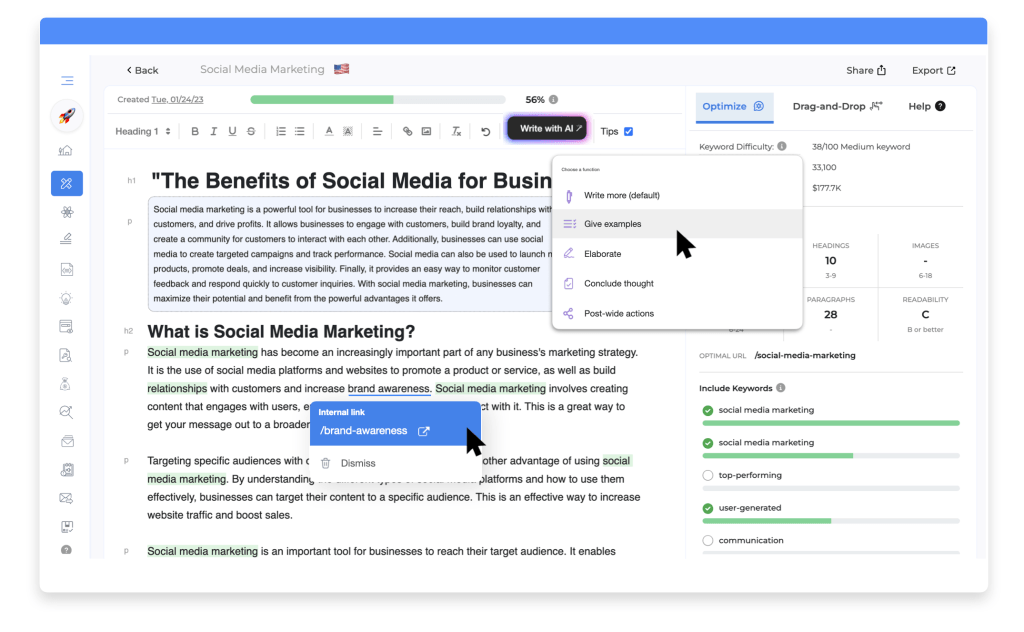
Probeer GrowthBar — onze best beoordeelde AI-schrijftool voor SEO
Onderzoek zoekwoorden, genereer een SEO-geoptimaliseerde outline op basis van de actuele zoekresultaten en schrijf vervolgens binnen enkele minuten met AI het volledige artikel. Controleer en verbeter bestaande content, werk samen met je team en train een aangepast model op basis van je eigen schrijfstijl.
Over FAQ-secties
Wat maakt een goede FAQ?
Een goede FAQ beantwoordt vragen die mensen daadwerkelijk stellen, in de bewoordingen die zij gebruiken om ze te stellen. De naam moet letterlijk worden opgevat: dit moeten veelgestelde vragen zijn, afkomstig uit supporttickets, verkoopgesprekken en zoekopdrachten, en niet bedacht om een sectie op te vullen.
Elk antwoord moet op zichzelf staan. Iemand die bij één vraag terechtkomt, heeft de andere vragen niet gelezen. Een antwoord dat afhankelijk is van het vorige antwoord, schiet daarom tekort voor de meeste mensen die het lezen.
De lengte is waar de meeste FAQ's de mist in gaan, in de ene of de andere richting. Eén zin die de vraag ontwijkt, is nutteloos; vier alinea's zijn geen FAQ meer. Twee of drie zinnen die daadwerkelijk antwoord geven, zijn meestal precies goed.
Waar de vragen vandaan moeten komen
- Supporttickets en chatlogs, waarin echte verwarring wordt vastgelegd in plaats van ingebeelde verwarring.
- Salesgesprekken, waarin bezwaren zich blijven herhalen totdat duidelijk is dat het om patronen gaat.
- Zoekopdrachten waarmee bezoekers op je site terechtkomen, vooral de lange, conversationele zoekopdrachten.
- De vragen die concurrenten beantwoorden, omdat die laten zien waar de markt naar vraagt.
- Alles wat je twee keer persoonlijk hebt uitgelegd; de derde uitleg hoort op de pagina.
Veelgemaakte fouten
- Vragen verzinnen die niemand stelt, meestal om een zoekterm waarvoor je wilt ranken erin te verwerken.
- Antwoorden met marketingtekst in plaats van met een antwoord.
- Vragen formuleren in bedrijfstaal in plaats van in de taal van de klant.
- Echt belangrijke informatie verstoppen in een FAQ omdat het lastig was om die ergens anders te plaatsen.
- FAQ-schema toevoegen aan een gedeelte dat eigenlijk geen FAQ is, wat het risico op een handmatige penalty met zich meebrengt.
Hoe dit verband houdt met AI-zoekopdrachten
FAQ-secties zijn bij uitstek geschikt om te worden geciteerd, omdat de indeling overeenkomt met de manier waarop vragen worden gesteld. Een duidelijk geformuleerde vraag, gevolgd door een zelfstandig antwoord, komt dicht in de buurt van de ideale eenheid voor extractie.
Daarom loont het om vragen te formuleren zoals mensen ze daadwerkelijk typen, inclusief de langere, conversationele formuleringen die assistenten ontvangen in plaats van de ingekorte zoekwoordvormen die in een zoekvak worden ingevoerd.
De kanttekening is eerlijkheid. Een sectie die is opgebouwd om te worden geëxtraheerd in plaats van om te helpen, valt op, en FAQ-schema op content die niet echt een FAQ is, brengt een reëel risico met zich mee.
Waar een FAQ-generator wel en niet bij helpt
Hij is goed voor volledigheid. Geef je een onderwerp op, dan brengt een FAQ-generator voor de hand liggende vragen naar voren die je zelf nog niet had bedacht of opgeschreven. Dat is een redelijk startpunt voor een checklist.
Hij kan niet weten welke vragen je klanten daadwerkelijk stellen, en precies daarin zit het verschil tussen een nuttige FAQ en opvulling. Je supportinbox weet dat wel; de generator doet op basis van het onderwerp slechts een gok.
De betrouwbare methode is om de generator te gebruiken voor de structuur en formulering, en vervolgens zijn vragen te vervangen door je echte vragen en zijn antwoorden door wat je mensen daadwerkelijk vertelt.
De FAQ-generator gebruiken
Voeg je onderwerp toe en de tool stelt vragen en antwoorden voor. Een specifiek onderwerp levert veel meer bruikbare vragen op dan een breed onderwerp.
Controleer vervolgens elke vraag aan de hand van bewijs dat iemand deze vraag stelt en herschrijf elk antwoord in de woorden die je zou gebruiken als iemand het rechtstreeks aan je vroeg. Verwijder alles wat alleen is blijven staan omdat het aannemelijk klonk.
Waar je nu verder kunt gaan
Een FAQ werkt het best wanneer ook de pagina eromheen goed gestructureerd is. Voorzie deze correct van markup met schema-markup, controleer de header-tags die de structuur van de pagina bepalen en stel ondersteunende content op met de tool AI-blogpostgenerator.
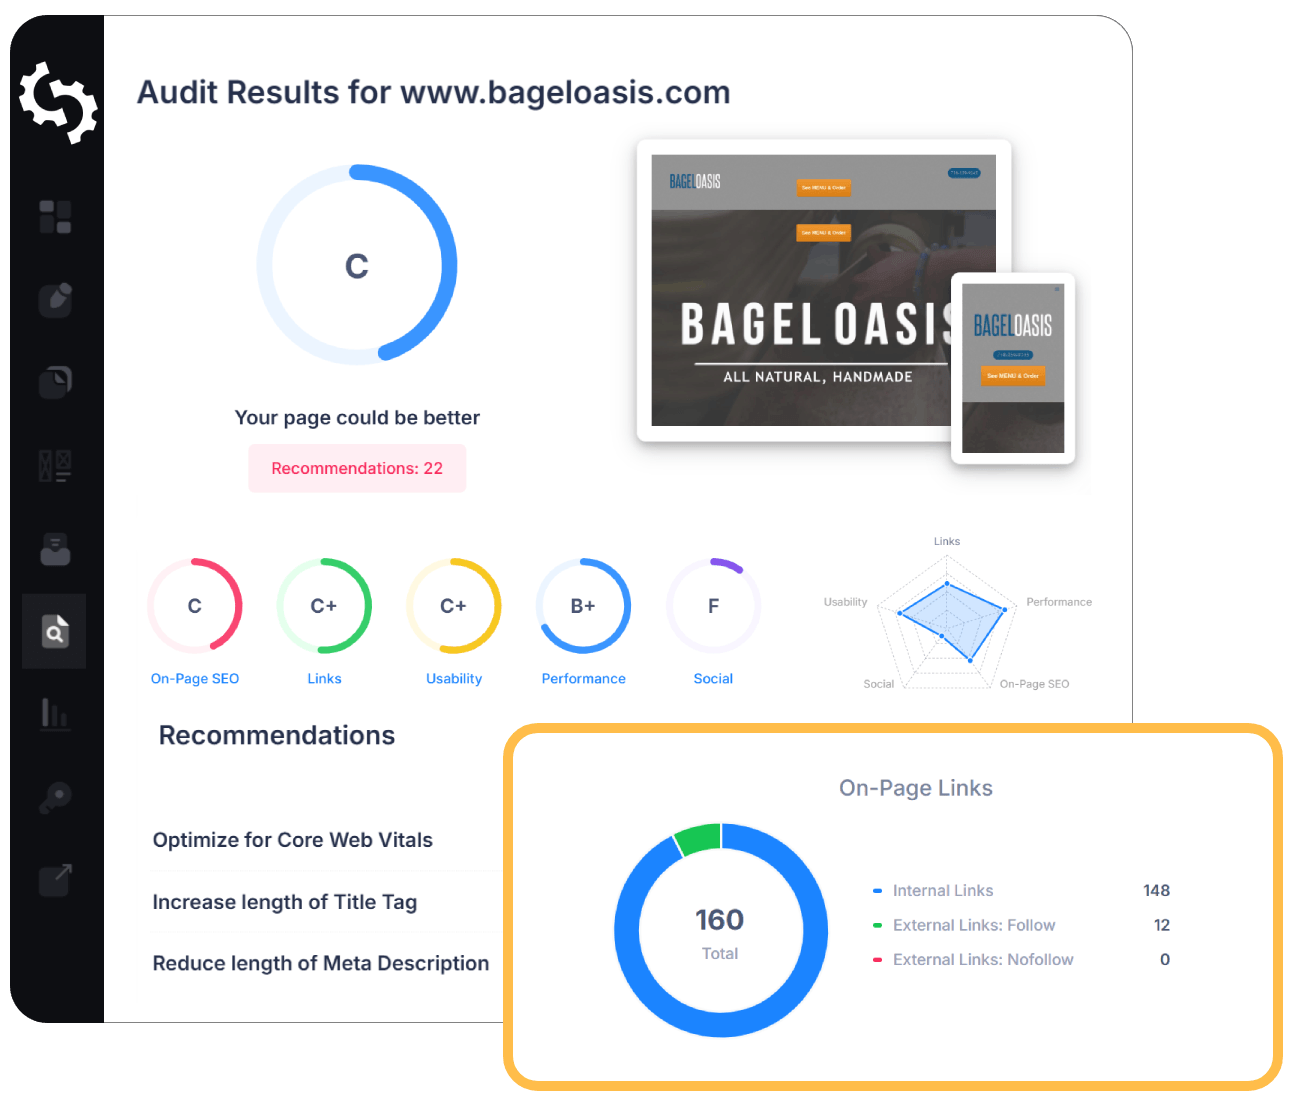
Voer in enkele seconden een SEO-audit uit voor elke website
+ Uitgebreide SEO-/GEO-tools voor elke functie
Voer meer dan 100 controles uit op je website op het gebied van On-Page SEO, gebruiksvriendelijkheid, prestaties, social media en links. Nu met GEO in elk rapport. SEOptimer biedt ook zoekwoordonderzoek, ranktracking, backlinkanalyse en een volledige sitecrawler.
Verder lezen
Meer Zien
How to Structure Content to Get Cited in AI Answers
How to Structure Content for AI Citations
Put the main point at the top of each section.
Make headings describe the exact quest...
Google AI Overviews: A Deep Dive into How Search is Changing
Google AI Overviews is one of the latest announcements and product updates from the search engine giant this year.
Google held its a...
SEO-copywritingchecklist voor hoger gerangschikte content
Het volgen van een SEO-copywritingchecklist is erg belangrijk als je de zoekmachinezichtbaarheid van je website wilt verbeteren en je concur...
LLM Optimization: How to Get Cited in AI Answers
LLM optimization can help increase the chances of your website being mentioned or cited in answers generated by ChatGPT, Gemini, Claude, and...