Test de balise Noindex
Le test de balise Noindex de SEOptimer vérifie si une balise "Noindex" est présente sur votre page web, vous aidant à l'identifier et à la supprimer facilement pour garantir que votre page est indexable.
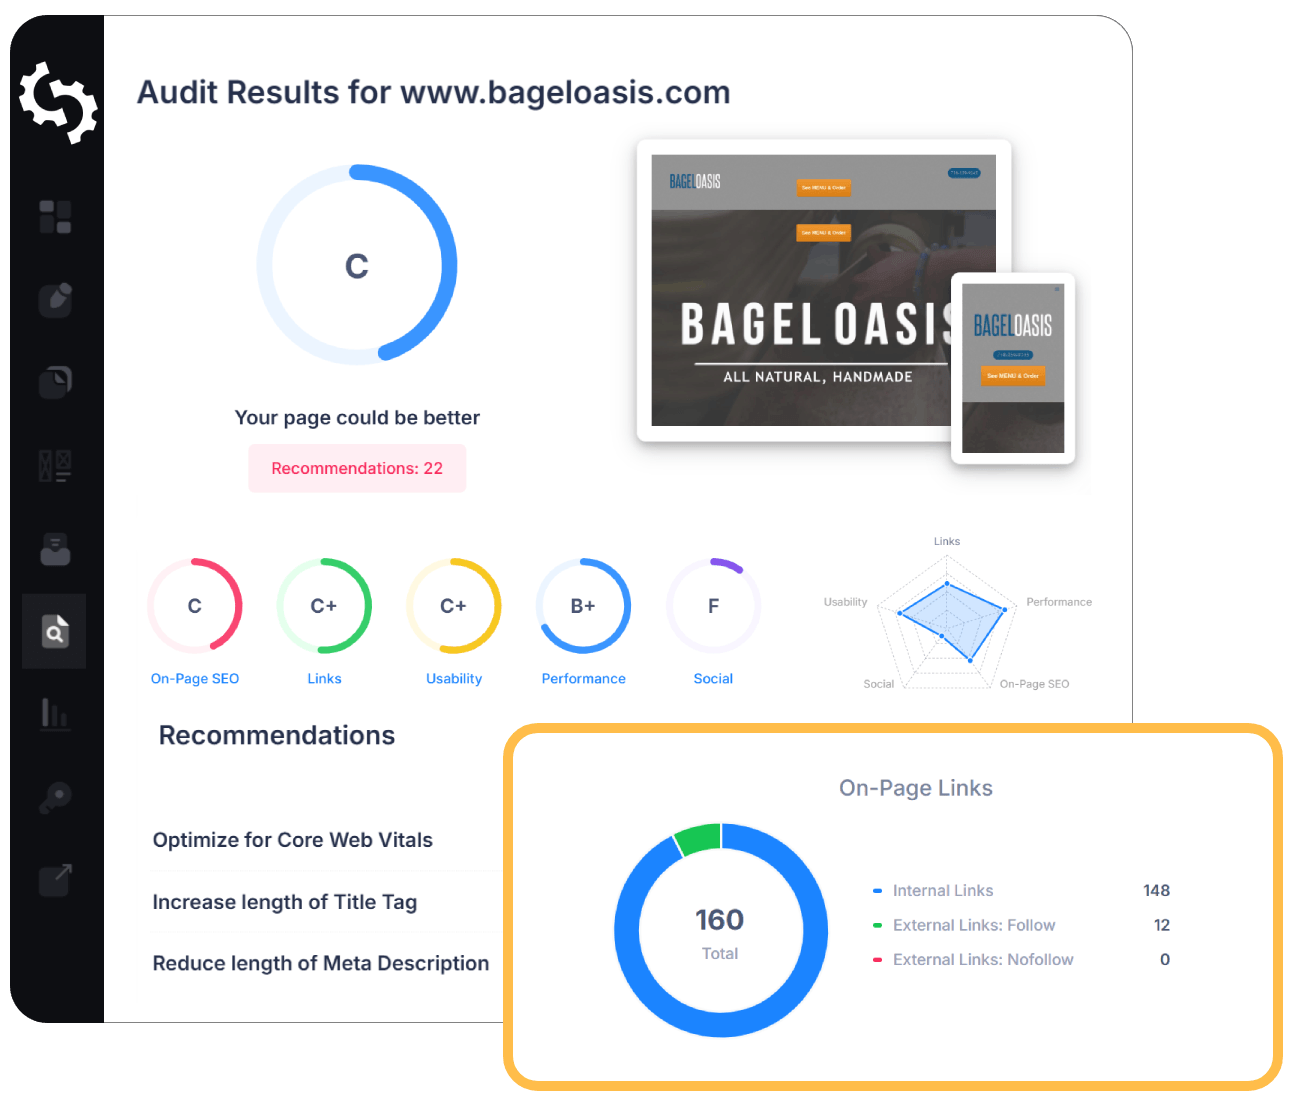
Auditez n’importe quel site en quelques secondes
+ Des outils SEO / GEO complets pour chaque fonctionnalité
Effectuez plus de 100 vérifications sur votre site concernant le SEO on-page, l’utilisabilité, les performances, les réseaux sociaux et les liens. Désormais avec le GEO dans chaque rapport. SEOptimer propose également la recherche de mots-clés, le suivi du classement, l’analyse des backlinks et un crawler complet du site.
À propos des balises meta noindex
Qu’est-ce qu’une balise noindex ?
Le noindex est-il toujours important en 2026 ?
Comment le noindex s’applique à la recherche par IA
Bonnes pratiques du noindex
- Utilisez noindex plutôt qu’un blocage dans robots.txt lorsque l’objectif est d’empêcher une page d’apparaître dans les résultats.
- Ne confondez pas les deux. Une page bloquée ne peut jamais être lue, donc son instruction noindex n’est jamais détectée.
- Vérifiez ce point après chaque déploiement, en particulier lorsque la préproduction et la production partagent la même base de code.
- Laissez les liens d’une page noindex être suivis, sauf si vous avez une raison précise de ne pas le faire.
- Excluez les pages noindex de votre sitemap XML ; les y soumettre envoie des signaux contradictoires.
- Supprimez cette directive dès qu’une page est prête à être trouvée, car le rétablissement n’est pas instantané.
Erreurs courantes
- Mettre le site en ligne alors que la directive noindex de la préproduction est toujours en place : c’est la version la plus dommageable de cette erreur.
- L’appliquer à l’ensemble du site via un réglage d’extension prévu pour une seule page.
- Utiliser noindex sur des pages que vous souhaitez également positionner, en pensant que cela permet de gérer le contenu dupliqué ; une balise canonical est l’outil approprié dans ce cas.
- Bloquer une page dans le fichier robots.txt et lui ajouter noindex, de sorte que la directive ne soit jamais lue.
- Oublier qu’une directive peut également être transmise dans l’en-tête HTTP plutôt que dans le code HTML.
Ce que cet outil vérifie
Pour aller plus loin
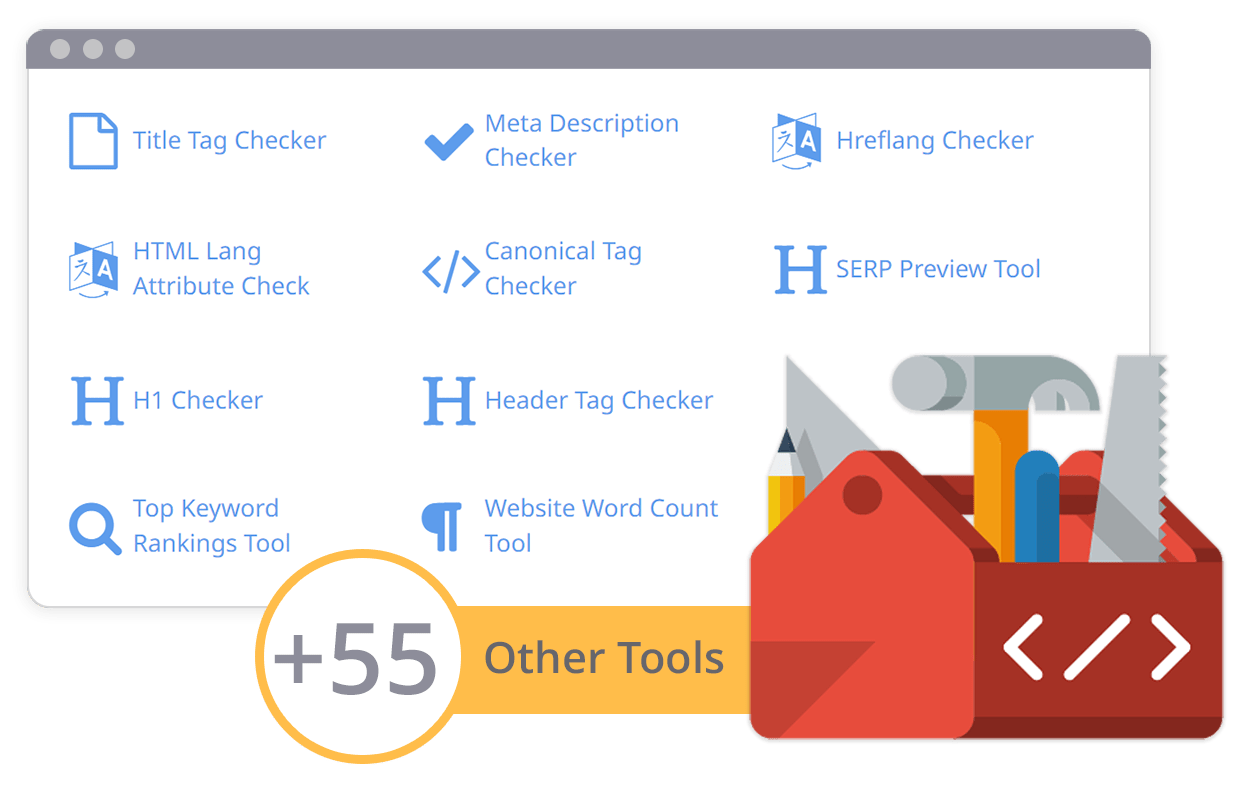
Boîte à outils SEO complète avec plus de 55 outils
Vérifiez les titres, les méta-descriptions, les en-têtes, les données structurées Schema, les Core Web Vitals, le SSL et le fichier robots.txt. Générez des balises méta, des sitemaps et des règles .htaccess, minifiez vos fichiers CSS, JS et HTML, et rédigez du contenu grâce à nos outils de rédaction IA — instantanément et gratuitement.
Lectures complémentaires
Voir plus