Pemeriksa Pemblokiran Crawler AI
Pemeriksa Pemblokiran Crawler AI SEOptimer membaca robots.txt Anda dan melaporkan apakah GPTBot, ClaudeBot, PerplexityBot, serta crawler AI lainnya diizinkan untuk membaca situs Anda.
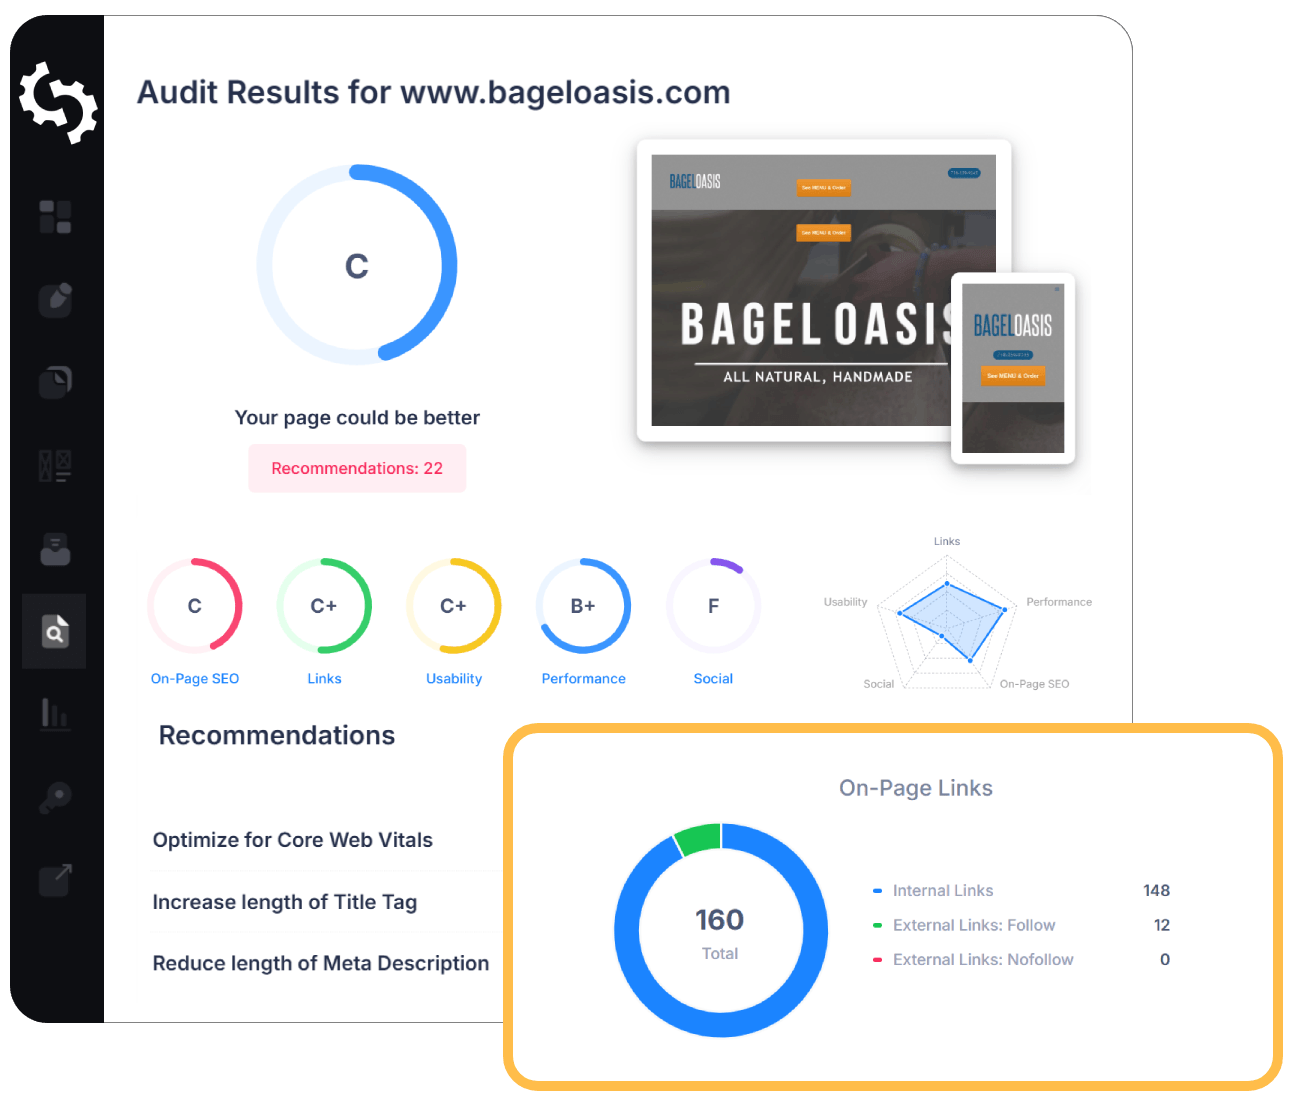
Audit SEO Situs Apa Pun dalam Hitungan Detik
+ Alat SEO / GEO Komprehensif untuk Setiap Kebutuhan
Jalankan lebih dari 100 pemeriksaan di situs web Anda yang mencakup SEO On-Page, Kegunaan, Performa, Sosial, dan Tautan. Kini dengan GEO di setiap laporan. SEOptimer juga menawarkan riset kata kunci, pelacakan peringkat, backlink, dan perayap situs lengkap.
Tentang Pemblokiran Perayap AI
Perayap mana yang dimaksud?
Perusahaan AI menjalankan crawler mereka sendiri dengan nama masing-masing, dan crawler tersebut terpisah dari crawler mesin pencari yang sudah Anda kenal. GPTBot dan OAI-SearchBot milik OpenAI, ClaudeBot milik Anthropic, PerplexityBot milik Perplexity, Google-Extended mengatur pelatihan Gemini, dan CCBot memasok data ke Common Crawl, yang menjadi sumber pelatihan bagi banyak model.
Masing-masing mematuhi robots.txt dengan cara biasa, sehingga aturan yang mencantumkan user-agent-nya menentukan apakah crawler tersebut dapat membaca situs Anda. Pemeriksa ini membaca robots.txt Anda dan melaporkan apakah crawler-crawler tersebut diblokir.
Diblokir bukan berarti secara otomatis salah. Itu adalah sebuah keputusan, dan tujuan pemeriksaan ini adalah memastikan bahwa keputusan tersebut memang disengaja.
Mengapa situs akhirnya memblokirnya secara tidak sengaja
Penyebab yang umum adalah aturan yang berlaku menyeluruh. robots.txt yang ditulis untuk mencegah scraper dengan larangan yang luas juga menangkap crawler ini, dan tidak ada pemberitahuan bahwa hal tersebut telah terjadi.
Penyebab kedua adalah pewarisan konfigurasi. Banyak penyedia hosting, plugin keamanan, dan konfigurasi CDN menambahkan pemblokiran crawler AI secara default selama 2023 dan 2024, lalu situs menggunakannya tanpa ada yang sengaja memilihnya.
Yang ketiga adalah keputusan yang tepat pada saat itu. Pemblokiran yang ditambahkan ketika kekhawatirannya adalah data pelatihan kini juga mencegah halaman Anda dibaca untuk keperluan sitasi, yang merupakan kompromi yang berbeda.
Kompromi yang patut dipertimbangkan
Ada dua hal berbeda yang dilakukan crawler ini, dan keduanya perlu dipisahkan. Sebagian mengambil konten untuk melatih model, yang tidak memberikan apa pun secara langsung kepada Anda. Sebagian lainnya mengambil halaman untuk menjawab pertanyaan yang sedang diajukan saat ini, lalu mencantumkan sumbernya.
Memblokir jenis kedua membuat Anda tidak muncul dalam jawaban yang menampilkan pesaing Anda. Memblokir jenis pertama merupakan sikap yang wajar bagi penerbit yang menjadikan kontennya sebagai produk.
User-agent didokumentasikan secara terpisah karena alasan ini, sehingga Anda dapat mengizinkan crawler yang mencantumkan sumber dan menolak crawler yang hanya mengonsumsi konten.
Apakah ini penting pada 2026?
Hal ini semakin penting setiap tahun karena semakin banyak penelitian dilakukan di dalam asisten. Halaman yang tidak dapat diambil tidak dapat dikutip, dan tidak ada laporan peringkat yang akan memberi tahu Anda bahwa hal itu sedang terjadi.
Asimetri inilah yang membuatnya layak diperiksa, bukan sekadar diasumsikan. Mengizinkan perayap tidak memerlukan biaya apa pun jika nantinya Anda berubah pikiran; tidak terlihat selama setahun karena aturan bawaan adalah hal yang mahal, dan sering kali tidak disadari saat itu terjadi.
Yang diperiksa alat ini
Alat ini mengambil robots.txt Anda dan mencari aturan yang dapat mencegah perayap AI utama membaca situs Anda, lalu melaporkan perayap mana yang diblokir.
Alat ini membaca file sebagaimana dipublikasikan, sehingga aturan yang ditambahkan oleh plugin atau CDN akan muncul sama seperti aturan yang Anda tulis sendiri. Jika ada sesuatu yang diblokir tanpa disengaja, di situlah tempat pertama yang perlu diperiksa.
Ke mana selanjutnya
Akses perayapan adalah gerbang pertama dari beberapa gerbang. Periksa apakah mesin pencari diblokir oleh file yang sama, tinjau file robots.txt secara keseluruhan, dan pastikan Anda menerbitkan file llms.txt yang mengarah ke halaman-halaman yang layak dibaca.
Kotak Alat SEO Komprehensif dengan Lebih dari 55 Alat
Periksa Title, Meta Description, Heading, Schema, Core Web Vitals, SSL, dan Robots.txt. Buat Meta Tag, Sitemap, dan aturan .htaccess, lakukan minifikasi pada CSS, JS, dan HTML, serta buat draf konten dengan Alat Penulisan AI kami—secara instan dan gratis.
Bacaan Selengkapnya
Lihat Lebih Banyak
AI Crawlability: Should You Let AI Bots Access Your Site and How Can You Check?
As more people use ChatGPT, Claude, Perplexity, and Google’s AI search features, AI crawlability is becoming increasingly important for webs...

Robots.txt - Panduan Utama
Apa itu Robots.txt? Robots.txt adalah file dalam bentuk teks yang memberi instruksi kepada bot crawler untuk mengindeks atau tidak meng...
What is AI Visibility and What Influences It?
Key Takeaway: AI visibility is how often your brand gets mentioned, cited, or recommended in answers from AI tools like ChatGPT, Gemini, Per...
LLM Optimization: How to Get Cited in AI Answers
LLM optimization can help increase the chances of your website being mentioned or cited in answers generated by ChatGPT, Gemini, Claude, and...
Google AI Mode: What it Means for Search, SEO, and Your Traffic
Google’s AI Mode isn’t just a beta experiment anymore, it officially launched at Google I/O 2025, Google’s flagship developer conference foc...
10 Best Software for AI Visibility in Search (2026)
Best Software for AI Visibility in Search
SEOptimer
Profound
Otterly
SE Ranking
Rankscale
Peec AI
Scrunch
ZipTie...