Controle voor geblokkeerde zoekmachines
De controle voor geblokkeerde zoekmachines van SEOptimer leest je robots.txt en laat zien of Google en andere zoekmachines worden geblokkeerd bij het crawlen van je website.
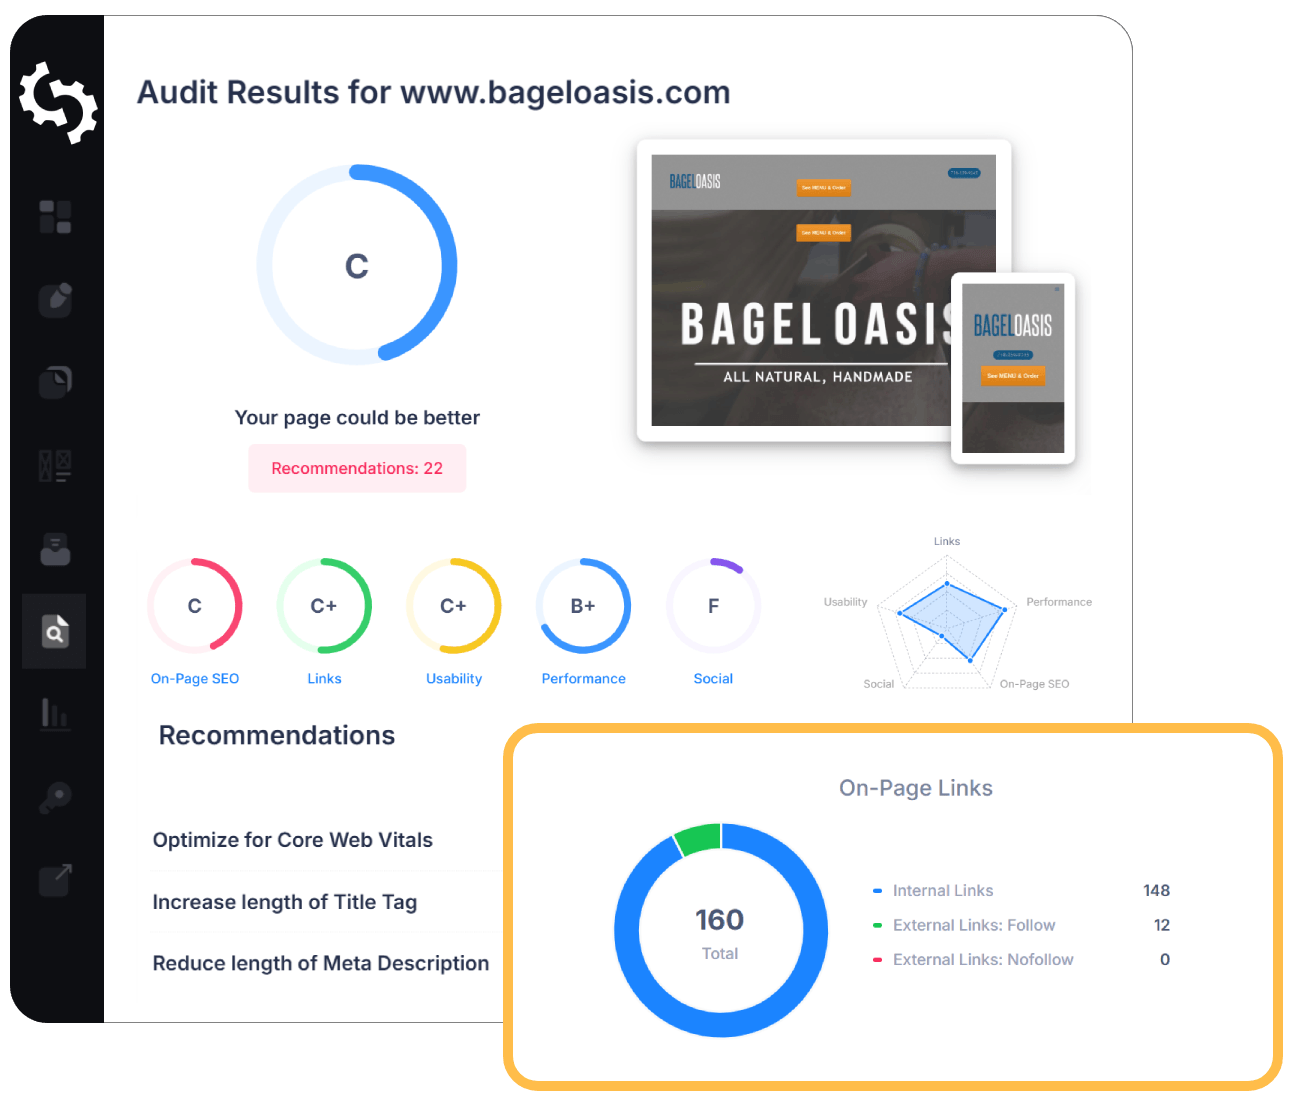
Voer in enkele seconden een SEO-audit uit voor elke website
+ Uitgebreide SEO-/GEO-tools voor elke functie
Voer meer dan 100 controles uit op je website op het gebied van On-Page SEO, gebruiksvriendelijkheid, prestaties, social media en links. Nu met GEO in elk rapport. SEOptimer biedt ook zoekwoordonderzoek, ranktracking, backlinkanalyse en een volledige sitecrawler.
Over het blokkeren van zoekmachines in Robots.txt
Wat betekent geblokkeerd zijn eigenlijk?
Een robots.txt-regel vertelt een crawler dat deze een pad niet mag ophalen. Als de regel op de hele site wordt toegepast, voorkomt dit dat zoekmachines iets kunnen lezen. Alles wat daarna komt, werkt dan ook niet meer: nieuwe content wordt niet ontdekt en bestaande pagina's raken verouderd en verdwijnen uiteindelijk uit de index.
Deze checker leest je robots.txt en meldt of zoekmachines de toegang tot je site wordt ontzegd.
Het is de schadelijkste regel die een site kan bevatten, en hij is maar één regel lang.
Hoe het gebeurt
Bijna altijd per ongeluk, en bijna altijd op dezelfde manier: er wordt een stagingomgeving gebouwd met een sitebrede disallow om deze uit de zoekresultaten te houden, en het bestand gaat samen met de rest van de deployment live.
Contentmanagementsystemen hebben hier hun eigen variant van. In de meeste daarvan bestaat een instelling als ‘zoekmachines ontmoedigen’, die tijdens de ontwikkeling wordt aangevinkt en daarna zelden nog wordt bekeken.
Er gaat niets zichtbaar mis wanneer dit gebeurt. De site werkt perfect voor elke menselijke bezoeker, waardoor het vaak weken duurt voordat iemand de daling in het verkeer in verband brengt met de oorzaak.
Blokkeren is niet hetzelfde als verwijderen
Dit is het deel dat mensen verrast. Een geblokkeerde pagina kan nog steeds in de zoekresultaten verschijnen, zonder beschrijving, omdat de crawler de opdracht kreeg de pagina niet te lezen, maar niet om deze uit de resultaten te laten.
Om een pagina correct uit de zoekresultaten te houden, heb je een noindex-directive nodig. Dat betekent dat de crawler de pagina moet mogen ophalen om deze te kunnen zien. Blokkeren en de-indexeren werken elkaar tegen.
Robots.txt is dus het verkeerde middel voor privacy. Het bestand regelt het crawlen, niet de zichtbaarheid, en het bestand zelf is openbaar.
Is robots.txt nog steeds relevant in 2026?
Het is de voorwaarde voor alles wat volgt. Voor content, structuur, snelheid en links moet een crawler de pagina in de eerste plaats kunnen bereiken, en geen daarvan helpt als dat niet kan.
Het heeft er inmiddels ook een tweede functie bij gekregen. Datzelfde bestand bepaalt nu of AI-crawlers je site mogen lezen, en daarmee of je pagina's kunnen worden geciteerd in gegenereerde antwoorden.
Voor een bestand dat meestal maar uit een handvol regels bestaat, draagt het een buitensporig grote verantwoordelijkheid.
Wat deze tool controleert
Het haalt robots.txt op van het domein dat je invoert en rapporteert of de regels zoekmachines zouden verhinderen je site te crawlen.
Een geslaagde controle betekent dat er op siteniveau niets is dat ze blokkeert. Het bevestigt niet dat afzonderlijke paden toegankelijk zijn. Controleer daarom afzonderlijk een pagina die ondanks deze geslaagde controle niet wordt geïndexeerd.
Waar je nu verder kunt gaan
Als crawlen is toegestaan, zijn de volgende vragen: wat kan worden ontdekt en wat is bewust uitgesloten? Controleer het volledige bestand robots.txt, ga na of je XML-sitemap aanwezig en actueel is, en bevestig dat geen noindex-tag stiekem doet wat robots.txt niet doet.
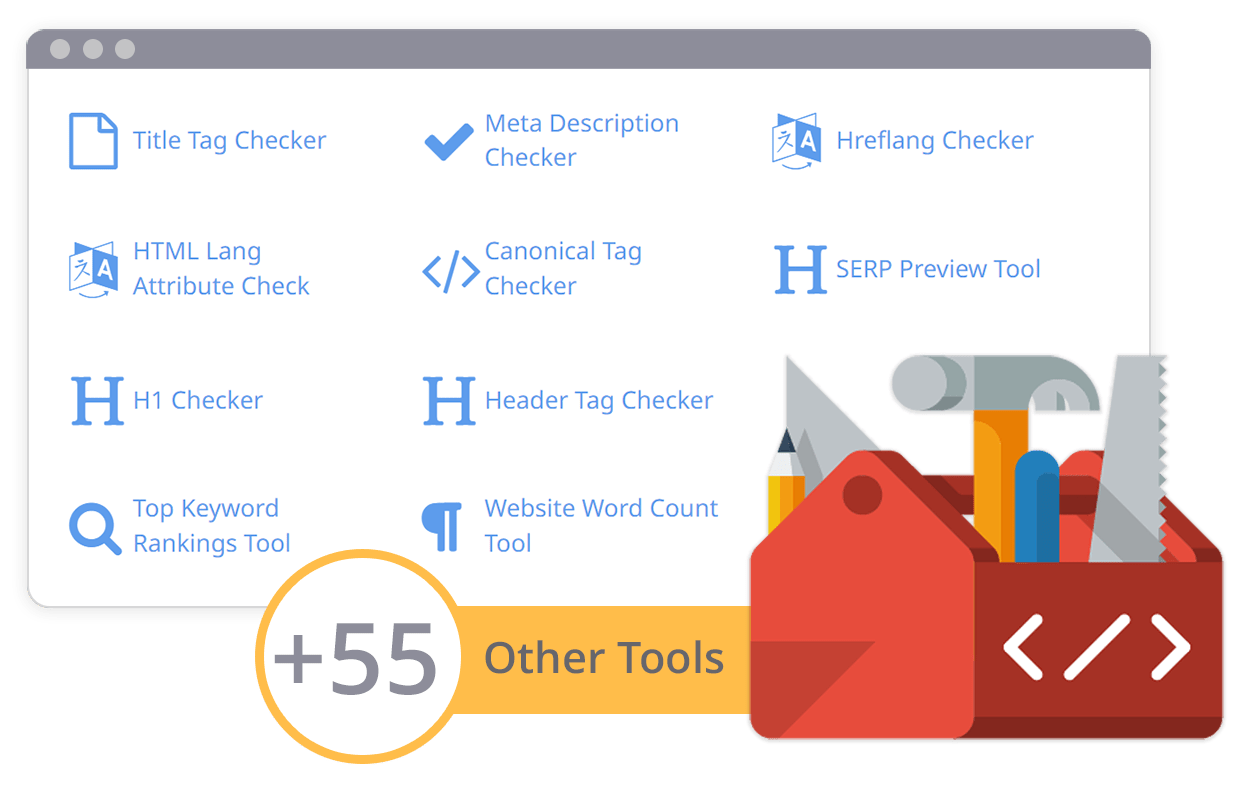
Uitgebreide SEO-toolbox met meer dan 55 tools
Controleer titels, metabeschrijvingen, koppen, Schema, Core Web Vitals, SSL en Robots.txt. Genereer metatags, sitemaps en .htaccess-regels, verklein CSS, JavaScript en HTML, en maak content met onze AI-schrijftools — direct en gratis.
Verder lezen
Meer Zien
Robots.txt - De Ultieme Gids
Wat is Robots.txt? Robots.txt is een bestand in tekstvorm dat bot crawlers instrueert om bepaalde pagina's wel of niet te indexeren. He...
How to Fix 'Indexed, though blocked by robots.txt' in Google Search Console
If you received the warning ‘Indexed, though blocked by robots.txt’ notification in Google Search Console, you’ll want to fix it as soon a...
What is a Google Crawler?
You know when you use Google to search for a service, or find information? And once the page loads there is always one website at the very t...
Crawl Depth in SEO: What is It & How to Improve It?
Crawl depth influences how efficiently Google can index your content.
Googlebot has limited time and server resources. Therefore, th...