Robots.txt チェッカー
SEOptimerのRobots.txtチェッカーは、ウェブサイトにrobots.txtファイルが設定されているかどうかをチェックし、サイトへの検索エンジンクローラーのアクセスを管理するのを助けます。
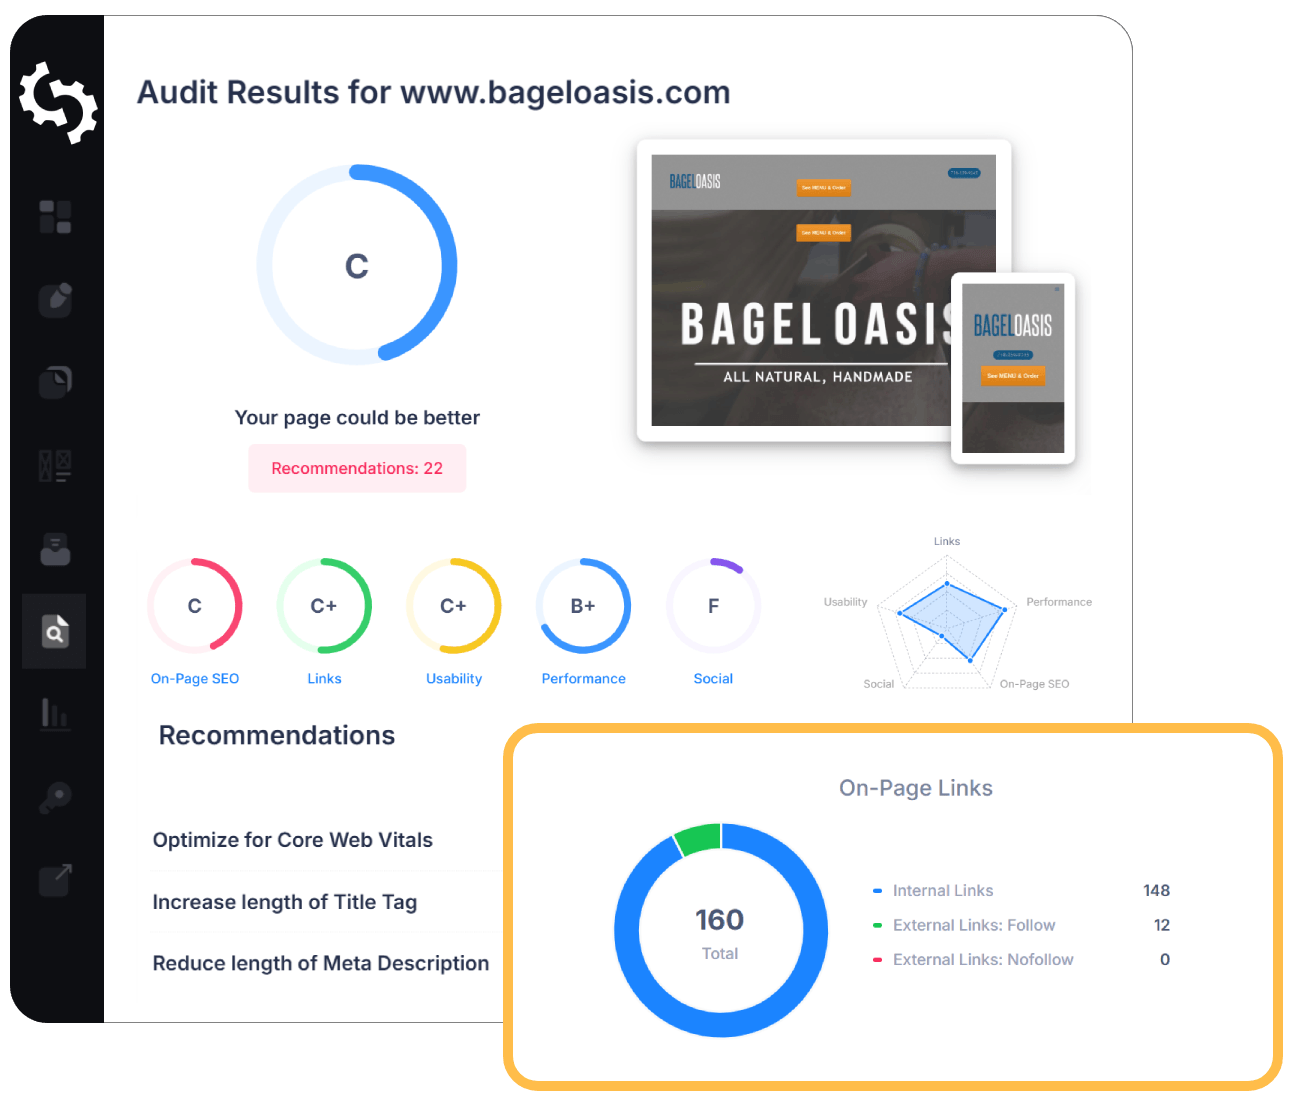
数秒であらゆるサイトをSEO監査
+ あらゆる機能に対応する包括的なSEO/GEOツール
オンページSEO、ユーザビリティ、パフォーマンス、ソーシャル、リンクに関して、ウェブサイトを100項目以上チェックします。すべてのレポートにGEO分析も追加されました。SEOptimerでは、キーワード調査、順位追跡、バックリンク分析、サイト全体のクローリングも利用できます。
Robots.txtについて
robots.txtファイルとは何ですか?
Robots.txtは、ドメインのルートに置かれるプレーンテキストファイルで、自動アクセスする訪問者に対して、サイト内のどの部分にリクエストを送ってよいかを伝えます。ほとんどのクローラーが、ページを取得する前に最初に確認するものであり、ウェブ上で機械に対してどのコンテンツを対象外とするかを示す最も古い慣習です。
これはクロールを制御するものであり、インデックス登録を制御するものではありません。この違いは、今でも多くの人が混同しています。URLをブロックすると、クローラーによる取得は停止できますが、そのURLが検索結果に表示されるのを確実に防げるわけではありません。ページ自体が読み込まれなくても、そのページを指すリンクの存在だけでインデックス登録される可能性があるためです。
robots.txt チェッカーは実行する価値があります。たった1文字の誤配置でファイル全体の意味が変わるにもかかわらず、トラフィックが消失するまで、サイト上には問題の兆候が何も現れないからです。
2026年になってもrobots.txtは重要ですか?
従来の役割は変わっていません。管理者用パス、サイト内検索結果、ファセットナビゲーション、そして本来ユーザーが訪れるべきではないページにクロールバジェットを消費させる無数のパラメータの組み合わせから、クローラーを遠ざけることです。
新たな役割は、より大きなものになっています。現在、このファイルはサイト所有者が、どのAIクローラーに自分のコンテンツへのアクセスを許可するかを決める場所になっています。これは、これまでほとんどのサイト所有者が答える必要のなかった問いです。現在では、主要なAI企業はいずれも名前の付いたクローラーを運用しており、その大半がこのファイルの指示に従います。
そのため、robots.txt はサイト上で実際に重大な影響を及ぼす数少ないファイルの1つであり、プラットフォームのデフォルト設定をそのまま引き継ぐのではなく、意識的に見直す価値があります。
robots.txtとAI検索の関係
現実的に判断しなければならない選択であり、誰にとっても正解となる答えがあるわけではありません。AIクローラーをブロックすると、コンテンツが学習データや回答の材料として利用されるのを防げます。一方で、現在ますます多くの人が頼るようになっている回答内で引用される可能性も、完全になくなります。
この2つの効果は対称ではありません。ブロックの効果はほぼ絶対的である一方、引用されるかどうかは不確実です。そのため、コンテンツが商品そのものなのか、それとも商品のマーケティング手段なのかによって、選択は異なります。
サブスクリプションを販売するパブリッシャーであれば、合理的な理由でブロックすることがあります。一方、ページを見つけてもらうことを目的としているビジネスでは、通常はブロックしません。重要なのは、そのファイルに実際に意図した内容が記載されていることです。
robots.txt のベストプラクティス
- ファイルはドメインのルートに配置してください。それ以外の場所に置くと、完全に無視されます。
- 機密性の高いコンテンツを隠すために、決して使用しないでください。このファイルは公開されており、隠したかったパスを見つける最も速い方法は、そのファイルを読むことです。
- ページを検索結果から除外することが目的であれば、クロールをブロックするのではなく、noindex ディレクティブを使用してください。
- 同じページでこの2つを併用しないでください。ブロックされたページは決して読み取られないため、そのページの noindex も認識されません。
- クローラーが別途指示されなくても見つけられるよう、ファイル内で XML サイトマップを参照してください。
- サブドメインには専用のファイルを用意してください。メインドメインのルールは、サブドメインには適用されません。
よくある間違い
- 公開後も開発時のルールでサイト全体をブロックしたままにすること。これは、このエラーの中でも最も深刻なケースです。
- CSSやJavaScriptをブロックすると、訪問者に表示される状態で検索エンジンがページをレンダリングできなくなります。
- ブロックしたURLが検索結果から消えると思い込むこと。説明文なしで検索結果に残る場合があります。
- 存在しないユーザーエージェント文字列用のルールを記述しているため、何も影響を受けません。
- 自分のサイトマップで送信しているクロールパスをブロックしており、矛盾した指示を送っています。
このツールがチェックする項目
robots.txtチェッカーはドメインのルートからファイルをリクエストし、ファイルが存在するかどうかを報告します。
ルールを評価するのではなく、ファイルの存在を確認するだけなので、サイト全体を誤ってブロックしているファイルでも、正しいファイルとまったく同じように合格します。実際に何が記載されているかを読むことが重要で、それには約1分しかかかりません。
次に行うこと
Robots.txt is one of three instructions that decide whether a page is found. Build or revise your file with the robots.txtジェネレーター, check the noindexタグチェッカー that keep a fetched page out of results, and make sure your XMLサイトマップジェネレーター lists the pages you do want crawled.
55種類以上のツールを備えた包括的なSEOツールボックス
タイトル、メタディスクリプション、見出し、スキーマ、コアウェブバイタル、SSL、robots.txtをチェック。AIライティングツールを使って、メタタグ、サイトマップ、.htaccessルールを生成し、CSS、JS、HTMLを圧縮、コンテンツの草案を即座に無料で作成できます。
関連記事
もっと見る
Robots.txt - 究極のガイド
Robots.txtとは何ですか? Robots.txtは、特定のページをインデックスに登録するかしないかをボットクローラーに指示するテキスト形式のファイルです。これは、あなたのサイト全体のゲートキーパーとしても知られています。ボットクローラーの最初の目的は、サイトマッ...
Google Search Consoleで「Indexed, though blocked by robots.txt」を修正する方法
Google Search Consoleで「Indexed, though blocked by robots.txt」という警告通知を受け取った場合、検索エンジンの結果ページ(SERPS)でページがランク付けされる能力に影響を与えている可能性があるため、できるだけ早く修正する...
Google Crawlerとは何ですか?
Googleを使ってサービスを検索したり、情報を見つけたりする時のことを知っていますか?ページが読み込まれると、常に一番上にあるウェブサイトがあります。 Google検索エンジンの結果ページ(SERP)で1位に位置するサイトは、すべてのクリックの大部分を獲得します。...
SEOにおけるクロールの深さ: それは何ですか & どうやって改善するのですか?
クロールの深さは、Googleがコンテンツをどれだけ効率的にインデックスできるかに影響します。 Googlebotは限られた時間とサーバーリソースを持っています。したがって、クロール予算、つまり特定の時間枠内でGooglebotがあなたのサイトでクロールできるページ...
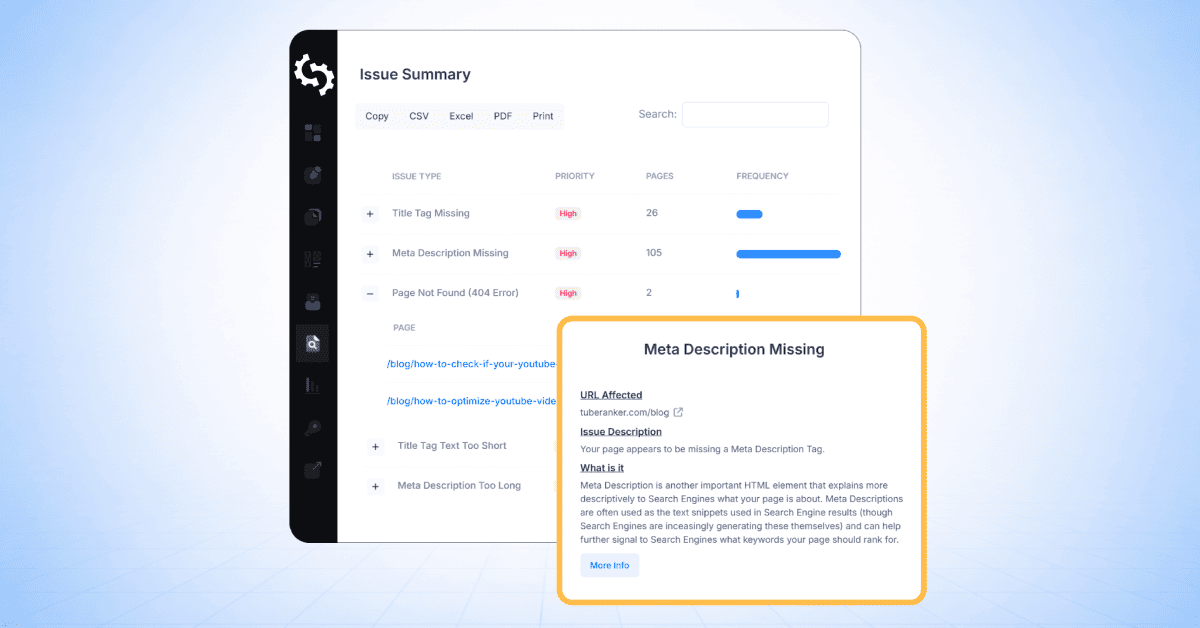
SEOptimerのSEOクローラーの使い方
SEOptimerのSEOクローラーは、ウェブサイト上のページをスキャンして監査し、大規模な技術的SEOの問題を特定するのに役立ちます。
ページを一つずつ確認する代わりに、クローラーはサイトの構造をレビューし、複数のURLにわたるSEO要素を分析し、インデックス化、ユーザビ...
XMLサイトマップの究極ガイド
サイトマップとは何ですか? サイトマップは、各セクションの下にあるURLとデータを特定しながらウェブサイトを整理する方法です。XMLドキュメントには検索エンジンボットへの指示が含まれています。 また、サイトマップは、親グループの下にサブページがどの...